我給 Grok Bot 一個 2,500 美元模擬帳戶,22 小時後變成 8,750 美元:這套 6 Agent 系統到底做了什麼?
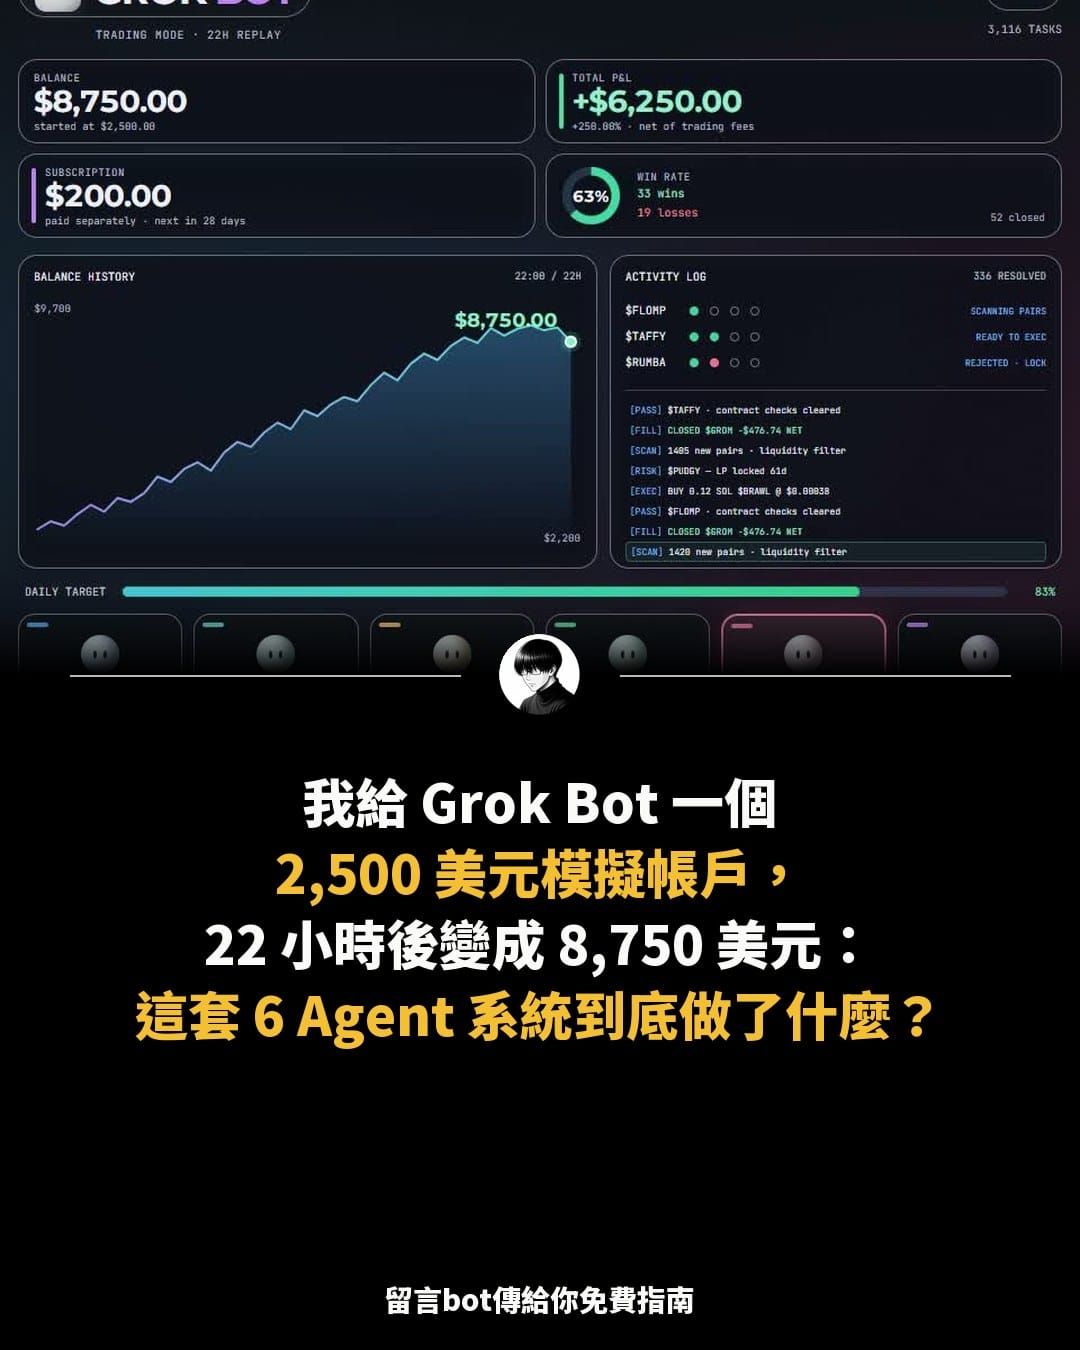
如果把一筆模擬資金交給 AI,讓它連續運作 22 小時,結果會怎麼樣?
這次的測試從 2,500 美元開始。
22 小時後,儀表板顯示的結算餘額是:
8,750 美元。
相較於起始資金,增加 6,250 美元,模擬報酬率為 250%,期末餘額是起始帳戶的 3.5 倍。
這個數字已經扣除模擬交易費用,但畫面中的 200 美元訂閱費是另外計算,沒有直接從交易餘額中扣除。
乍看之下,這似乎是一台可以自動賺錢的 AI 交易機器。
但開始以前,必須先把最重要的前提說清楚:
這是一段模擬介面展示,不是真實帳戶的交易績效,也不是未來收益預測。
影片沒有證明有人真的把 2,500 美元投入市場,再從券商帳戶提出 8,750 美元。
它呈現的是一套 AI 多代理交易系統的概念:
讓 6 個 AI Agent 同時運作,分別處理掃描交易對、檢查流動性、審查合約、建立決策與記錄成交等工作,最後把所有過程集中顯示在同一個儀表板。
真正值得研究的不是「22 小時賺了多少」。
而是:
如何把一個複雜又容易出錯的流程,拆成六個可以被監督、記錄與否決的 AI 角色。
影片裡的 6 個 AI Agent
儀表板下方可以看到六個角色:
- ODEN
- VIRA
- KESH
- NOLU
- TAMB
- RYZO
它們會輪流進入工作狀態。
畫面右側的 Activity Log,則持續顯示系統正在執行的任務,包括:
- 掃描交易對
- 檢查流動性
- 審查合約
- 比較訊號
- 建立模擬訂單
- 記錄成交
- 關閉部位
- 更新帳戶餘額
這和只建立一個「交易機器人」有很大的差別。
傳統做法通常把所有工作放進同一段程式:
找到標的、判斷方向、決定部位、下單、停損與統計結果。
只要其中一個判斷出錯,錯誤就可能一路傳到最後。
多代理架構則是把工作拆開。
每個 Agent 只處理自己負責的部分,再把結果交給下一個角色審查。
22 小時內,帳戶怎麼變化?
根據這次模擬測試提供的紀錄,帳戶餘額變化如下:
- 第 0 小時:2,500.00 美元
- 第 6 小時:4,469.91 美元
- 第 12 小時:6,587.66 美元
- 第 18 小時:8,759.22 美元
- 第 22 小時:8,750.00 美元
這條曲線不是一路向上。
獲利交易會把餘額推高,虧損交易則會讓它回落。
在第 18 小時,帳戶一度到達 8,759.22 美元;接近結束時又回吐了一部分,最後停在 8,750 美元。
雖然回吐幅度不大,但這個細節仍然很重要。
因為真正的交易系統,不可能只展示最後結果。
如果只看到起點和終點,我們無法知道中間曾經承受多大的風險。
這次一共完成了多少筆交易?
這段重播期間,另外關閉了 40 筆交易:
- 25 筆獲利
- 15 筆虧損
把原本已存在的交易紀錄一起計算,儀表板最後共有:
- 52 筆已平倉交易
- 33 筆獲利
- 19 筆虧損
- 約 63% 勝率
63% 勝率看起來不錯,但單獨看勝率,無法判斷一套策略是否真的有效。
假設一個系統:
- 每次獲利 10 美元
- 每次虧損 100 美元
就算勝率高達 80%,仍然可能虧錢。
因此,除了勝率,至少還需要知道:
- 平均獲利
- 平均虧損
- 盈虧比
- 最大回撤
- 單筆最大損失
- 連續虧損次數
- 每筆交易使用的部位
- 使用多少槓桿
- 買賣價差
- 模擬滑價
- 未成交訂單如何處理
- 測試市場與測試期間
如果這些資料沒有呈現,就不能只根據「63% 勝率」判斷系統能不能投入真實資金。
250% 報酬率代表什麼?
從 2,500 美元增加到 8,750 美元,代表帳戶成長了 250%。
這是一個極端高的短期結果。
但高報酬通常也意味著系統可能承擔了非常高的風險,例如:
- 使用高槓桿
- 單筆投入比例過大
- 同時持有高度相關的部位
- 在高波動市場中頻繁交易
- 沒有充分模擬滑價
- 只測試特定行情
- 資料或參數對測試區間過度配合
所以一套模擬系統顯示高收益時,第一個問題不應該是:
「我怎麼複製這個報酬?」
而應該是:
「這項報酬承擔了多少風險?」
美國商品期貨交易委員會提醒,AI 無法預測未來或突然發生的市場變化;評估自動交易系統時,也必須考慮費用、價差及其他真實成本。CFTC:AI 不會把交易 Bot 變成印鈔機
換句話說,250% 不是這場測試的結論。
它只是需要被進一步查證的結果。
Activity Log 比收益數字更重要
影片中最值得注意的,其實不是左上角的帳戶餘額,而是右側持續更新的活動紀錄。
因為如果沒有紀錄,我們只會看到 AI 最後給出的答案:
- 買進
- 賣出
- 獲利
- 虧損
卻不知道它為什麼這樣做。
一套可以被檢查的 AI 系統,至少要保存:
- 任務開始時間
- 執行任務的 Agent
- 使用的資料來源
- 資料截止時間
- 掃描過哪些標的
- 哪些候選標的被排除
- 排除原因
- 流動性檢查結果
- 合約檢查結果
- 模擬進場價格
- 模擬出場價格
- 費用計算方式
- 最終損益
- 是否有人為修改
這些紀錄的作用不是讓畫面看起來更專業。
而是當結果出錯時,可以往回追查:
是資料錯了、模型判斷錯了、風險規則失效,還是模擬成交條件不合理?
沒有活動紀錄的 AI 自動化,本質上是一個黑箱。
為什麼需要六個 Agent?
你可能會想:
既然 Grok Bot 可以一次完成很多工作,為什麼還要拆成六個角色?
因為「能完成」和「能被管理」是兩回事。
如果把所有任務交給同一個 Agent,它可能同時扮演:
- 機會發現者
- 資料查證者
- 看多分析師
- 看空分析師
- 風險管理員
- 最終決策者
這會產生一個明顯問題。
當 AI 一開始認為某個標的值得交易,它後面很容易繼續尋找支持自己結論的證據。
這就是確認偏誤。
把任務拆成多個角色,可以要求不同 Agent 從不同角度提出意見。
例如:
- 一個 Agent 只負責找機會
- 一個只負責資料品質
- 一個只負責風險
- 一個專門找反對證據
- 一個計算模擬部位
- 最後一個才整合所有報告
系統的目標不是讓六個 Agent 全部同意。
而是讓不同角色彼此制衡。
這六個角色可以怎麼分工?
影片沒有完整公開每個 Agent 的系統指令,因此不能僅靠名字斷定它們真正的內部設定。
但如果要建立一套可查證的模擬系統,可以把六個角色設計成以下分工。
ODEN:市場掃描
ODEN 負責掃描交易對,尋找:
- 成交量異常
- 價格異動
- 波動率變化
- 短期動能
- 不同市場之間的價差
- 需要進一步檢查的候選標的
它只能提交候選名單,不能直接決定建立部位。
VIRA:資料與流動性檢查
VIRA 負責確認候選標的是否真的具備可模擬交易的條件:
- 成交量是否充足
- 買賣價差是否合理
- 市場深度是否足夠
- 價格資料是否最新
- 交易對是否仍然有效
- 是否可能因流動性不足產生巨大滑價
如果流動性不合格,就算訊號看起來再漂亮,也應該直接停止。
KESH:合約與標的安全審查
如果系統研究的是加密貨幣或鏈上資產,KESH 可以負責:
- 合約地址
- 代幣權限
- 流動性池
- 持幣集中度
- 可否正常賣出
- 是否存在可疑稅率
- 合約是否可以被任意修改
- 資料來源是否一致
這個角色的任務,不是判斷價格會不會上漲。
而是避免系統根據不存在、錯誤或危險的標的建立模擬交易。
NOLU:訊號與反方審查
NOLU 負責把技術訊號、新聞與市場狀況放在一起比較。
它必須同時列出:
- 支持建立部位的證據
- 反對建立部位的證據
- 尚未確認的資訊
- 訊號可能失效的情境
如果所有 Agent 都只負責找進場理由,系統一定會過度交易。
所以 NOLU 應該被要求主動尋找:
為什麼這筆交易可能是錯的?
TAMB:風險與部位控制
TAMB 負責計算:
- 最大允許部位
- 單筆最大損失
- 每日損失上限
- 總帳戶曝險
- 持倉相關性
- 模擬停損位置
- 預估費用與滑價
它必須擁有否決權。
只要交易超過風險限制,即使其他 Agent 全部看多,也不能建立部位。
RYZO:記錄與最終協調
RYZO 負責收集前面五份結果,再決定:
- 建立模擬交易
- 縮小模擬部位
- 等待更多資料
- 完全拒絕
它同時需要把每一步寫入 Activity Log。
如果各 Agent 的結論互相衝突,最安全的結果應該是:
不交易。
而不是要求系統無論如何都要產生一筆交易。
模擬介面最容易造成什麼誤解?
做得精緻的儀表板,很容易讓人把「看起來正在運作」理解成「真的具有獲利能力」。
但畫面上出現:
- 即時跳動的數字
- 不斷更新的任務
- Agent 狀態燈
- 資金曲線
- 勝率
- 成交紀錄
都不代表資料一定來自真實市場,也不代表每筆模擬成交都能在真實環境重現。
一個展示介面可以預先設定:
- 帳戶成長速度
- 勝負交易數量
- 結算餘額
- 活動紀錄內容
- Agent 啟用順序
- 平滑的資金曲線
這不代表它是在欺騙觀眾。
只要清楚標示為「模擬介面展示」,它就可以作為產品概念、工作流程與視覺原型。
真正有問題的是把介面動畫包裝成已驗證的真實投資績效。
訂閱費為什麼要另外列出?
影片中的儀表板顯示 200 美元訂閱費,並標示為另外計費。
這個細節值得注意。
因為評估任何 AI 自動化系統時,不能只計算交易損益。
還需要包括:
- AI 模型訂閱費
- 市場資料費
- API 使用費
- 自動化平台費
- 伺服器費
- 券商手續費
- 鏈上 Gas Fee
- 買賣價差
- 滑價
- 維護與監控成本
假設一個系統每個月模擬賺 150 美元,卻需要支付 200 美元訂閱費、100 美元資料費與其他服務成本,它仍然沒有正向的淨效益。
所以更完整的績效應該是:
交易結果-所有交易成本-工具成本-資料成本=最終淨結果
不能只把交易獲利放大,卻把固定成本藏在另一個欄位。
為什麼 52 筆交易仍然不夠?
52 筆交易可以用來發現問題,但還不足以證明策略具有長期優勢。
因為這 52 筆可能全部發生在:
- 同一個市場
- 同一段上漲行情
- 相似的波動環境
- 相同時間帶
- 高度相關的交易對
- 對策略特別有利的條件
如果要判斷系統是否穩定,至少要測試:
- 上漲行情
- 下跌行情
- 震盪行情
- 高波動環境
- 低波動環境
- 高流動性標的
- 低流動性標的
- 重大新聞期間
- 網路或資料延遲情境
同時還要避免在測試完成後,不斷修改規則直到歷史結果變漂亮。
這種做法稱為過度配合歷史資料。
它可能讓回測或重播非常好看,進入新市場環境後卻立刻失效。
Grok Bot 可以協助什麼?
Grok Bot 比較適合負責的工作包括:
- 搜尋公開資訊
- 整理社群討論
- 摘要市場事件
- 建立結構化研究報告
- 比較不同來源
- 依照規則檢查資料
- 整理活動紀錄
- 協調不同研究角色
如果連接 X,官方說明指出,Grok Bot 可以搜尋貼文、讀取時間軸、查看提及、趨勢及書籤等內容。X 官方 Grok Bot 說明
但 X 官方同樣提醒,Grok Bot 可能犯錯,使用者仍然需要審查它提出的行動,並對授權的第三方存取負責。X 官方 Grok 說明
所以它適合扮演研究助理。
不應該因為一段模擬動畫,就直接取得真實帳戶、資金轉移或出金權限。
這場測試真正值得學習的地方
如果只記住「2,500 美元變成 8,750 美元」,這個案例很快就會變成另一個 AI 暴利故事。
但如果把畫面拆開,可以看到更有價值的三件事。
第一,所有工作都被拆成不同角色。
第二,每一次行動都有紀錄。
第三,帳戶曲線同時顯示獲利與回落,而不是只呈現最後數字。
一套真正能使用的 AI 工作流程,不應只在成功時看起來很聰明。
它還必須在資料錯誤、訊號衝突與風險過高時,知道怎麼停止。
專屬資源:把 AI 當免費員工,你的隨身數位秘書已上線

大家都說 AI 很強,但每次打開對話框,看著閃爍的游標卻不知道該輸入什麼?你需要的不是花幾十個小時學寫程式,而是掌握直接套用的「溝通密碼」。
這份建立於 Notion 的《萬用實戰指令大禮包》,為你準備好 10 大核心領域、50+ 款隨插即用的實戰指令。無論是爆款短影音腳本生成、高情商職場信件、學術論文梳理,還是程式開發除錯,只需找到對應情境「複製、填空、發送」,一秒產出專家級成果。
- 🤖 跨模型完美支援: 無縫接軌 ChatGPT、Claude 3.5 Sonnet、Gemini 等主流工具。
- ⚡ 隨插即用,零學習門檻: 每個指令皆附帶「替換括號」,無腦操作即可發送。
- 🔄 一次買斷,持續更新: 隨 AI 進化每月擴充新指令,越早入手越划算。
盲目測試指令會耗費你無數個加班的夜晚,現在只需 NT$ 1,680 即可買斷這套高轉換率的生產力外掛(未來將隨內容擴充逐步調漲)。
遇到任何操作卡關,或希望未來新增特定情境指令?歡迎透過 Email 聯繫contact@denghao.info。(為了維持專業高效的溝通品質,來信請務必附上您的問題,並告訴我「您希望我怎麼稱呼您」)
想直接建立類似的模擬系統,我把完整版本整理進深度會員,裡面包含:
- 6 個 Agent 的完整角色提示詞
- 不用寫程式的手動執行方法
- Activity Log 統一紀錄格式
- 模擬成交與費用計算規則
- 防止 AI 捏造資料的限制
- 風險 Agent 的強制否決條件
- 30 天模擬驗證計畫
- 最終績效檢查清單